- 1 この記事の結論
- 2 この記事の要点
- 3 1. Concept Driftで監視する関係
- 4 2. なぜEAのモデル検証で重要なのか
- 5 3. 関連概念との違い
- 6 4. Concept Driftの代表的な変化パターン
- 7 5. 代表的な検出方法と選び方
- 8 6. MQL5開発者向けの設計へ翻訳する
- 9 7. MQL5で軽量なDrift Scoreを計算する実装例
- 10 8. Pythonで検証・可視化する方法
- 11 9. バックテスト・OOS・Walk Forwardで見るべき点
- 12 10. Drift検出後の対応をどう設計するか
- 13 11. 実運用で確認すべきリスク
- 14 12. よくある設計ミス
- 15 13. 導入手順
- 16 14. まとめ
- 17 関連トピック
- 18 FAQ
- 19 関連研究資料
この記事の結論
Concept Drift Detectionとは、時間の経過によって「市場の特徴量と、予測対象またはEAの成果との関係」が変化していないかを監視する考え方です。
価格やボラティリティの入力分布が変わっただけなら、まずCovariate Shiftの兆候であり、Concept Driftが起きたとは断定できません。
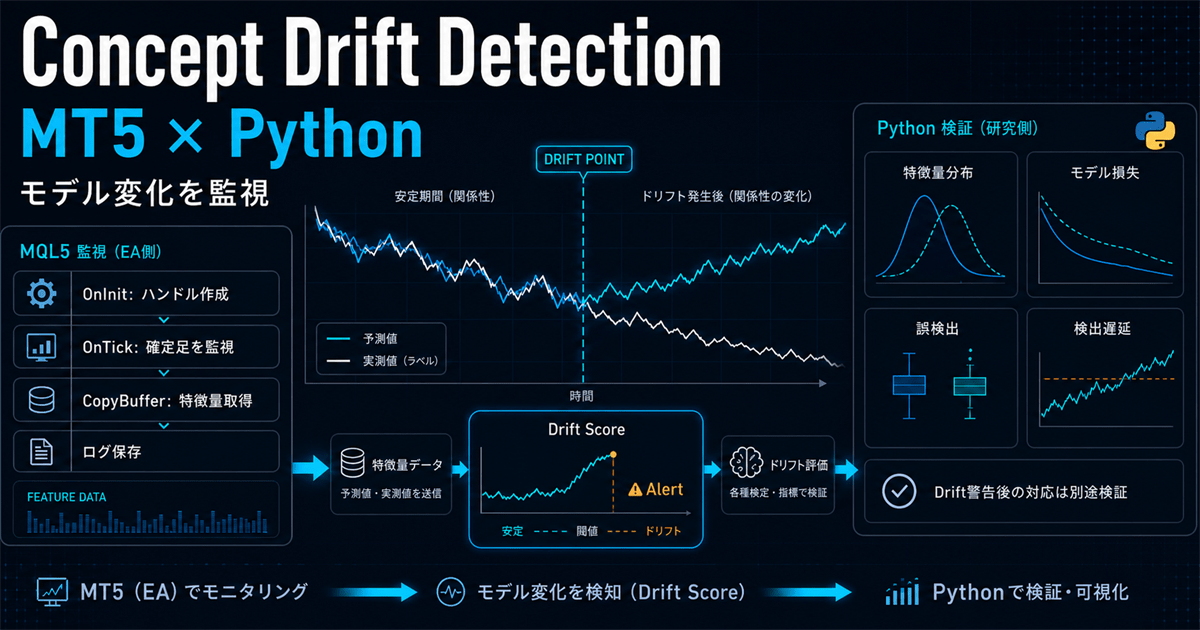
MetaTrader 5では特徴量取得、軽量な監視、ログ保存、リスク制御を担当し、Pythonでは統計検定、誤検出率の評価、可視化を行う構成が実用的です。
検出結果は売買シグナルではなく、EAを継続運用できるか判断するための監視情報として扱います。
この記事の要点
- Concept Driftは、特徴量と予測対象の関係
P_t(Y|X)が時間とともに変化することです。 - Covariate Shiftは入力分布
P(X)の変化、Regime Detectionは現在の市場状態の分類を中心に扱います。 - Drift Alertは売買シグナルではなくモデル監視に使い、その後の停止や再学習は別途検証します。
1. Concept Driftで監視する関係
【結論】
EAで監視するのは、特徴量と将来リターン、予測値と正解ラベル、売買判断と実現損益などの関係です。監視対象を具体化すると、単なる市場変動とモデル前提の変化を区別しやすくなります。
【定義】
時刻を t、特徴量を X、予測対象を Y とすると、Concept Driftは条件付き分布 P_t(Y|X) が時間とともに変化する状態です。
たとえば、過去には「ATRが低く、移動平均線の傾きが正なら、その後の一定期間で上昇しやすい」という関係が見られたとします。その関係が現在では弱くなったり、逆方向になったりした場合、監視対象となるConceptが変化しています。
Concept Drift Detectionの目的は、ドリフトが起きた可能性を知らせることです。将来の利益を予測する機能でも、新しいエントリーを作る機能でもありません。
1.1 EAで監視する対象を先に定義する
EAで「Concept」を曖昧にすると、何を検出したのか説明できません。最初に次の3点を固定します。
- 入力
X:リターン、ATR、スプレッド、出来高、移動平均線の傾きなど - 目的
Y:次の数本のリターン、上昇・下落ラベル、約定後の損益など - 関係の測り方:予測誤差、分類誤り、相関、条件別平均リターンなど
正解ラベルが得られるまで時間がかかる場合、検出も遅れます。将来10本分のリターンを目的変数にするなら、少なくとも10本が確定するまで、その予測の正誤を評価できません。
1.2 監視対象は売買成績だけではない
損益は重要ですが、取引回数が少ないと偶然の影響が大きくなります。Concept Driftを調べるときは、モデルの予測誤差とEAの売買成績を分けて記録します。
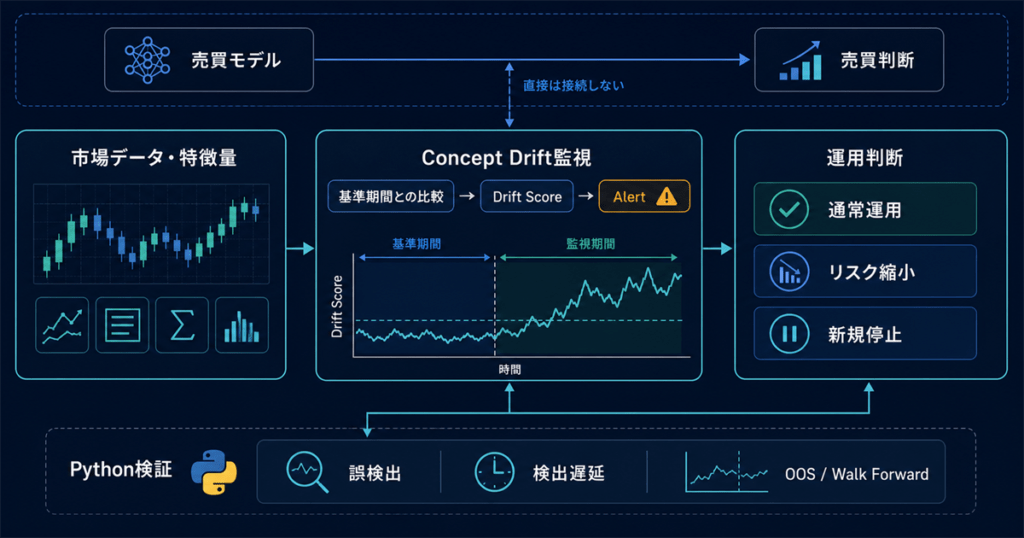
市場データ
  ↓
特徴量生成 ─────────→ 売買モデル → 売買判断
  ↓                         ↓
基準期間との比較       予測誤差・実現損益
  ↓                         ↓
Drift Score / Alert ←── 市場・モデル監視
  ↓
運用継続・リスク縮小・停止・再評価の判断
この分離により、「市場データは変化したが予測性能は保たれている」と「入力分布は似ているが予測性能が崩れた」を区別しやすくなります。
2. なぜEAのモデル検証で重要なのか
【結論】
金融時系列は一定の性質を保ち続けるとは限らないため、過去のバックテストだけでは現在の有効性を判断できません。Concept Drift Detectionは、運用中の前提が変化した可能性を継続的に点検する役割を持ちます。
EAのロジックは、開発時に選んだ期間、銘柄、時間足、スプレッド条件の影響を受けます。市場参加者、流動性、値動き、約定条件が変化すると、過去に選んだ特徴量と結果の関係も変わる場合があります。
一方、短期的な連敗やドローダウンだけでConcept Driftと判断するのは危険です。有限回の取引では、関係が変わっていなくても損益が偏ります。スプレッド拡大、スリッページ、通信遅延、取引頻度の低下など、モデル外の要因でも成績は悪化します。
2.1 検出が役立つ場面
- 予測モデルの誤差が基準期間より継続的に増えた
- 特定の相場条件でだけ分類誤りが増えた
- 特徴量と将来リターンの関係が弱くなった
- 学習時と運用時で予測確率の校正が崩れた
- 再学習や再最適化を検討する条件を客観化したい
2.2 検出だけでは答えられないこと
検出器は「変化の可能性」を示しますが、変化の原因や最適な対応を自動的に決めるわけではありません。警告が出ても、すぐに停止すべきか、ポジションサイズを下げるべきか、別モデルへ切り替えるべきかは、事前の比較検証が必要です。
3. 関連概念との違い
【結論】
Distribution ShiftまたはDataset Shiftは、学習時と運用時で同時分布 P(X,Y) が変化する状況を広く表す上位概念です。その中でも、Covariate Shiftは主に P(X) の変化、Concept Driftは P(Y|X) の時間変化を指します。Regime DetectionやChange Point Detectionは別の問いを扱います。
| 概念 | 主に観測するもの | 中心となる問い | EAでの例 | Concept Driftとの違い |
|---|---|---|---|---|
| Concept Drift | `P(Y | X)`、予測誤差、条件別成果 | 過去の入力と結果の関係は現在も成立するか | シグナル別の予測誤差を監視 |
| Distribution Shift / Dataset Shift | 同時分布 P(X,Y) | 学習時と運用時でデータ生成の分布が変わったか | 特徴量・ラベル・両者の関係を総合確認 | Concept DriftやCovariate Shiftを含み得る上位概念 |
| Covariate Shift | P(X)。`P(Y | X)`は基本的に維持 | 入力特徴量の分布だけが変わったか | ATRやリターン分布を比較 |
| Label Shift / Prior Probability Shift | P(Y) | 目的ラベルの比率が変わったか | 上昇・下落ラベルの比率を比較 | 入力とラベルの条件関係とは観点が異なる |
| Regime Detection | 市場状態や潜在状態 | 現在はどの相場状態か | トレンド、高ボラ、低ボラを分類 | 状態分類が中心 |
| Change Point Detection | 統計量や生成過程の切替時点 | いつ変化が起きたか | 平均・分散の変化時点を推定 | 何の関係が変わったかは別途定義が必要 |
| Structural Break | 回帰係数などの構造 | 関係に明確な断絶があるか | 特徴量係数の切替を検定 | 統計モデルの構造変化に焦点を当てる |
| Non-stationarity | 時系列全体の統計的性質 | 性質は時間を通じて一定か | 平均、分散、自己相関を確認 | より広い問題設定 |
3.1 Covariate Shiftが起きてもConcept Driftとは限らない
ATRの分布が高い側へ移動しても、ATRと将来リターンの関係 P(Y|X) が維持されていれば、観測された変化はCovariate Shiftとして整理できます。反対に、ATRの分布が大きく変わらなくても、ATRと目的変数の関係が変わればConcept Driftは起こり得ます。どちらも広い意味ではDistribution Shiftに含まれますが、EA監視では「入力が変わったのか」「入力と結果の関係が変わったのか」を分けて確認します。
3.2 相場状態の変化とConcept Driftは一対一ではない
相場がレンジからトレンドへ移っても、状態を入力に含むモデルが両方に対応できていれば、予測関係が崩れるとは限りません。Regime Changeの検出だけで、EAの期待値が失われたと断定することはできません。
3.3 ドローダウンは調査のきっかけ
ドローダウンは損益系列の悪化を示しますが、Concept Driftの直接的な証拠ではありません。予測誤差、特徴量分布、取引コスト、約定品質、取引回数を同時に確認する必要があります。
4. Concept Driftの代表的な変化パターン
【結論】
Concept Driftには、急激、緩やか、連続的、再発型などの形があります。検出窓と閾値は、想定する変化速度によって誤検出と検出遅延のバランスが変わります。
| 形態 | 変化の特徴 | EAで考えられる例 | 検出上の注意 |
|---|---|---|---|
| Sudden Drift | 短期間で急に切り替わる | 制度変更後に約定や値動きの関係が変化 | 短い窓は速いがノイズに反応しやすい |
| Gradual Drift | 新旧の関係が混在しながら移行 | 市場参加者の構成が徐々に変化 | 単一の変化時点を決めにくい |
| Incremental Drift | 関係が少しずつ連続的に変化 | ボラティリティとシグナル成果の関係が長期変化 | 長い窓では検出が遅れやすい |
| Recurring Drift | 過去の関係が再び現れる | 時間帯や流動性環境に応じて旧状態が再発 | 古いモデルを捨てるだけでは対応しにくい |
実際の金融データでは、ノイズ、分布変化、取引コスト変化が重なります。変化形態を一意に判定させるより、警告後の診断ログを残す方が実務では重要です。
5. 代表的な検出方法と選び方
【結論】
正解ラベルが継続的に得られる場合は予測誤差を監視し、ラベルが遅れる場合は特徴量分布の監視を補助的に使います。どの方法でも、誤検出率、検出遅延、必要サンプル数を同じ条件で比較します。
5.1 教師あり監視
予測と正解ラベルが揃う場合は、分類誤り、対数損失、二乗誤差、校正誤差などをストリームとして監視できます。入力と目的の関係変化を直接捉えやすい一方、金融では正解ラベルの確定が遅れ、取引しなかった局面のラベル設計も必要です。
5.2 教師なし監視
正解ラベルを使わず、リターン、ATR、スプレッド、特徴量ベクトルの分布を基準期間と比較します。KS統計量、PSI、平均・分散の差、距離尺度などが候補です。ただし、この監視で直接分かるのは主に P(X) の変化、つまりCovariate Shiftの兆候であり、Concept Driftを証明するものではありません。
5.3 ストリーム型の変化検出
DDMは主にオンライン分類の誤り率を監視します。ADWINは可変長ウィンドウ内の統計的差を使い、変化時に古い部分を縮める考え方です。Page-HinkleyやCUSUMは累積偏差から平均レベルの変化を調べます。検出対象の統計量が何かを明示しなければ、警告の意味は解釈できません。
| 方法 | 主な入力 | メリット | デメリット | 向いている場面 |
|---|---|---|---|---|
| 固定窓の平均・分散比較 | 連続値 | 実装と説明が簡単 | 窓幅への依存が強い | MQL5での軽量な一次監視 |
| DDM | 0/1の分類誤り | 予測性能の悪化を直接監視しやすい | 回帰や遅延ラベルには工夫が必要 | 分類モデルのオンライン監視 |
| ADWIN | 誤差や連続統計量 | 変化速度に応じて窓を調整する | 実装と評価が複雑 | Python側のストリーム監視 |
| Page-Hinkley / CUSUM | 連続統計量 | 小さな持続変化を捉えやすい | 初期値と閾値に敏感 | 損失や残差の平均変化 |
| KS検定・PSI | 特徴量分布 | ラベルなしで監視できる | 関係変化を直接は示さない | 入力データの健全性確認 |
| 変化点検出 | 時系列統計量 | 変化時点の推定に向く | Conceptの定義は別途必要 | 事後診断や区間分割 |
5.4 誤検出と検出遅延は同時に評価する
閾値を低くすると早く警告できますが、通常の変動をドリフトと誤認しやすくなります。閾値を高くすると誤検出は減る一方、変化後も古いモデルを長く使う可能性があります。
- 真の変化を検出できた割合
- 変化がない期間の誤警告数
- 変化発生から警告までのバー数
- 警告後に短期間で再警告する回数
- ラベル確定による構造的な遅延
- 計算時間とメモリ使用量
6. MQL5開発者向けの設計へ翻訳する
【結論】
MQL5では高度な学習器を無理に完結させず、確定足での特徴量取得、軽量なスコア計算、ログ保存、EAの運用制御を担当させます。統計検証、閾値探索、可視化、再学習はPython側に分離すると保守しやすくなります。
6.1 推奨する役割分担
| 処理 | MetaTrader 5側 | Python側 |
|---|---|---|
| 市場データ取得 | ティック、バー、スプレッド、インジケータ値 | エクスポート済みデータの読込 |
| 特徴量生成 | 実行に必要な軽量特徴量 | 大量特徴量、欠損処理、標準化 |
| Drift監視 | 移動統計、外部スコアの利用 | ADWIN、統計検定、多変量監視 |
| モデル処理 | 推論、モデルIDの切替 | 学習、再学習、閾値探索 |
| 運用制御 | 新規停止、ロット係数、ログ | 警告診断、レポート、承認フロー |
| 検証 | Strategy Tester、約定条件の確認 | OOS、Walk Forward、可視化 |
6.2 検出と対応を別モジュールにする
売買モデル
  └─ エントリー・決済判断

市場・モデル監視
  ├─ 特徴量と予測誤差を記録
  ├─ Drift Scoreを更新
  └─ Alertを発行

運用制御
  ├─ 通常運用
  ├─ リスク縮小
  ├─ 新規エントリー停止
  └─ 人手または外部処理で再評価
検出器が直接買い注文や売り注文を出す設計は避けます。警告の誤検出が、そのまま不要な売買へつながるためです。
6.3 状態遷移を明示する
EAの状態は、たとえば NORMAL、WARNING、PAUSED に分けます。1回の閾値超過だけで停止せず、連続回数、解除条件、最大停止時間、手動復帰条件を定義します。
NORMAL  ──閾値超過が連続──→ WARNING
WARNING ──正常化が継続────→ NORMAL
WARNING ──悪化が継続──────→ PAUSED
PAUSED  ──再評価条件を満たす→ NORMAL
7. MQL5で軽量なDrift Scoreを計算する実装例
【結論】
MQL5では、確定足の特徴量について古い基準窓と直近窓を比較し、標準化平均差を軽量な警告値として計算できます。この値はCovariate Shiftの一次監視であり、Concept Driftの確定判定ではありません。
次のサンプルEAは、確定足の正規化ATRを蓄積し、基準窓と直近窓の平均差を基準窓の標準偏差で割ります。売買処理は含めず、監視とログ出力だけに限定しています。
#property strict

input int    AtrPeriod        = 14;
input int    BaselineBars     = 120;
input int    RecentBars       = 30;
input double WarningThreshold = 2.0;
input int    RequiredBreaches = 3;

int      atrHandle = INVALID_HANDLE;
datetime lastBarTime = 0;
double   featureWindow[];
int      consecutiveBreaches = 0;

int OnInit()
{
   if(BaselineBars < 20 || RecentBars < 5 || RequiredBreaches < 1)
   {
      Print("Invalid monitoring parameters");
      return INIT_PARAMETERS_INCORRECT;
   }

   atrHandle = iATR(_Symbol, _Period, AtrPeriod);
   if(atrHandle == INVALID_HANDLE)
   {
      Print("Failed to create ATR handle. Error=", GetLastError());
      return INIT_FAILED;
   }

   ArrayResize(featureWindow, 0);
   return INIT_SUCCEEDED;
}

void OnDeinit(const int reason)
{
   if(atrHandle != INVALID_HANDLE)
      IndicatorRelease(atrHandle);
}

void AppendFeature(const double value, const int capacity)
{
   int size = ArraySize(featureWindow);
   if(size < capacity)
   {
      ArrayResize(featureWindow, size + 1);
      featureWindow[size] = value;
      return;
   }

   for(int i = 1; i < capacity; i++)
      featureWindow[i - 1] = featureWindow[i];

   featureWindow[capacity - 1] = value;
}

double MeanRange(const int startIndex, const int count)
{
   double sum = 0.0;
   for(int i = startIndex; i < startIndex + count; i++)
      sum += featureWindow[i];
   return sum / count;
}

double StdRange(const int startIndex, const int count, const double mean)
{
   double sumSquares = 0.0;
   for(int i = startIndex; i < startIndex + count; i++)
   {
      double difference = featureWindow[i] - mean;
      sumSquares += difference * difference;
   }
   return MathSqrt(sumSquares / MathMax(count - 1, 1));
}

void OnTick()
{
   datetime currentBarTime = iTime(_Symbol, _Period, 0);
   if(currentBarTime == 0 || currentBarTime == lastBarTime)
      return;
   lastBarTime = currentBarTime;

   if(BarsCalculated(atrHandle) < AtrPeriod + 2)
      return;

   double atrValue[1];
   ResetLastError();
   int copied = CopyBuffer(atrHandle, 0, 1, 1, atrValue);
   if(copied != 1)
   {
      Print("CopyBuffer failed. Error=", GetLastError());
      return;
   }

   double closePrice = iClose(_Symbol, _Period, 1);
   if(closePrice <= 0.0 || atrValue[0] <= 0.0)
      return;

   double normalizedAtr = atrValue[0] / closePrice;
   int capacity = BaselineBars + RecentBars;
   AppendFeature(normalizedAtr, capacity);

   if(ArraySize(featureWindow) < capacity)
      return;

   double baselineMean = MeanRange(0, BaselineBars);
   double baselineStd  = StdRange(0, BaselineBars, baselineMean);
   double recentMean   = MeanRange(BaselineBars, RecentBars);
   if(baselineStd <= 1e-12)
      return;

   double driftScore = MathAbs(recentMean - baselineMean) / baselineStd;
   if(driftScore >= WarningThreshold)
      consecutiveBreaches++;
   else
      consecutiveBreaches = 0;

   bool driftAlert = (consecutiveBreaches >= RequiredBreaches);
   PrintFormat("DriftScore=%.3f Alert=%s Feature=%.8f",
               driftScore,
               driftAlert ? "true" : "false",
               normalizedAtr);

   // driftAlertは売買シグナルではない。
   // 別の運用制御モジュールへ状態として渡す。
}
7.1 コードを読むときの重要点
OnInitでATRのインジケータハンドルを作成するBarsCalculatedで計算済みバーが足りるか確認するCopyBufferの開始位置を1にして確定足を取得する- 取得件数が1件でない場合はスコアを更新しない
OnDeinitでIndicatorReleaseを呼び出す- 連続した閾値超過を警告条件にして単発ノイズを抑える
- 警告値を注文処理へ直接接続しない
7.2 このコードで検出できないもの
正規化ATRの平均変化だけを見ているため、P(X) の変化、つまりCovariate Shiftの一部しか監視できません。予測誤差や将来リターンとの関係を使っていないので、このコードだけでConcept Driftと断定することはできません。
Concept Driftに近づけるには、予測時刻、予測値、後から確定した正解ラベル、損失をログへ保存し、損失系列の変化をPythonで監視します。
8. Pythonで検証・可視化する方法
【結論】
Pythonでは、特徴量の分布変化とモデル損失の変化を別々に計算し、警告の誤検出と検出遅延を可視化します。ラベルが確定した時刻をそろえ、未来情報が過去へ混入しないように処理することが最重要です。
次の例は、CSVに time、normalized_atr、model_loss が保存されている前提です。特徴量についてKS統計量を、モデル損失について標準化平均差を計算します。計算結果は検証用スコアであり、利益を示す数値ではありません。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy.stats import ks_2samp

df = pd.read_csv("ea_monitoring.csv", parse_dates=["time"])
df = df.sort_values("time").dropna()

baseline_size = 500
recent_size = 100
feature_ks = np.full(len(df), np.nan)
loss_shift = np.full(len(df), np.nan)

for end in range(baseline_size + recent_size, len(df) + 1):
    baseline = df.iloc[end-baseline_size-recent_size:end-recent_size]
    recent = df.iloc[end-recent_size:end]

    feature_ks[end - 1] = ks_2samp(
        baseline["normalized_atr"], recent["normalized_atr"]
    ).statistic

    base_mean = baseline["model_loss"].mean()
    base_std = baseline["model_loss"].std(ddof=1)
    if base_std > 1e-12:
        loss_shift[end - 1] = (
            recent["model_loss"].mean() - base_mean
        ) / base_std

df["feature_ks"] = feature_ks
df["loss_shift"] = loss_shift

fig, axes = plt.subplots(3, 1, figsize=(12, 9), sharex=True)
axes[0].plot(df["time"], df["normalized_atr"])
axes[0].set_ylabel("Normalized ATR")
axes[1].plot(df["time"], df["feature_ks"])
axes[1].set_ylabel("Feature KS")
axes[2].plot(df["time"], df["loss_shift"])
axes[2].axhline(2.0, color="red", linestyle="--")
axes[2].set_ylabel("Loss shift")
plt.tight_layout()
plt.show()
8.1 2種類のスコアを分けて解釈する
feature_ksだけが上昇:Covariate Shiftの兆候はあるが、P(Y|X)やモデル性能への影響は未確認loss_shiftだけが上昇:単純な入力監視では捉えにくい関係変化の可能性- 両方が上昇:Covariate Shiftとモデル性能変化が同時に起きた可能性。Concept Driftかどうかはラベルを使って追加確認
- どちらも平常で損益だけ悪化:約定、コスト、標本のばらつきを追加確認
8.2 ラベル遅延とデータ漏洩を防ぐ
予測時点では未知だった将来リターンを特徴量へ含めてはいけません。モデル損失は、正解ラベルが確定した時点で監視系列へ追加します。特徴量の標準化も、各時点より前のデータだけで学習します。
8.3 合成ドリフトで検出器を評価する
実データでは真のConcept Drift発生時点が分からないことが多いため、既知の時点で関係を変えた合成データを使います。前半を Y = X + noise、後半を Y = -X + noise として、検出までの遅延と誤警告数を測る方法があります。
合成データで良好でも、実市場で同じ結果になるとは限りません。合成検証は検出器の基本動作を確認する工程です。
9. バックテスト・OOS・Walk Forwardで見るべき点
【結論】
売買成績とDrift Detectionの性能は別々に評価します。OOSとWalk Forwardでは、過去データだけで基準窓・閾値・モデルを決め、未来区間で固定して検証します。
9.1 最低限固定する検証条件
- 対象銘柄とデータ提供元
- 時間足と検証期間
- ティック生成方法と約定方式
- スプレッド、手数料、スリッページ
- インサンプルとOOSの期間
- Walk Forwardの学習窓、評価窓、更新間隔
- 特徴量、目的変数、ラベル確定までの期間
- Drift Score、閾値、連続判定回数、解除条件
- 売買成績と検出性能の評価指標
9.2 4つの検証を使い分ける
| 検証 | 主な役割 | Concept Drift監視で見る点 | 限界 |
|---|---|---|---|
| バックテスト | 過去条件でEAを再生 | 警告前後の挙動、ログ整合性 | 将来の利益を保証しない |
| OOS検証 | 未使用期間で固定モデルを評価 | 閾値の汎化、誤警告、性能変化 | 1区間だけでは期間依存が残る |
| Walk Forward | 学習と評価を時系列で反復 | 再学習頻度と検出遅延の関係 | 分割方法自体が結果に影響する |
| フォワードテスト | 現在のデータと約定環境で確認 | ラベル遅延、ログ、実行安定性 | 観測に時間がかかる |
9.3 評価指標を分ける
売買側では、総損益、最大ドローダウン、勝率、損益比、取引回数、連敗数、期間別成績、スプレッド感応度、パラメータ感応度を確認します。検出側では、真陽性率、誤警告数、検出遅延、警告継続時間、再警告回数、計算負荷を確認します。
9.4 過剰最適化を避ける
閾値、窓幅、連続回数、解除条件を同じ期間で何度も選び直すと、検出器自体が過剰最適化されます。少数の説明可能な候補に絞り、OOSで評価し、Walk Forwardで期間依存性を確認します。
10. Drift検出後の対応をどう設計するか
【結論】
Drift検出後の対応は、検出アルゴリズムとは別の意思決定問題です。再学習、再最適化、モデル切替、リスク縮小、停止の各案を、誤警告時の損失も含めて比較します。
| 対応 | メリット | デメリット | 事前に決める条件 |
|---|---|---|---|
| ログだけ残す | 誤警告で運用を乱しにくい | 悪化への対応が遅れる | 調査周期と担当者 |
| ポジションサイズを縮小 | エクスポージャーを抑えやすい | 正常時の機会も減る | 縮小率、解除条件、最小ロット |
| 新規エントリーを停止 | 新しいリスクを増やさない | 誤警告時に取引機会を失う | 既存ポジションの扱い、最大停止時間 |
| 既存モデルへ切替 | 再発型の変化へ対応しやすい | 選択ルールが複雑 | モデルID、適用条件、失効条件 |
| 再学習・再最適化 | 新しいデータを反映できる | 過剰適合や頻繁な切替を招く | 最低データ数、OOS合格条件、承認手順 |
再学習を自動実行する場合でも、新モデルをすぐ実口座へ反映しない設計が安全です。候補モデルをOOS、Walk Forward、デモまたは小さいリスクのフォワード環境で評価し、合格条件を満たしたときだけ切り替えます。
11. 実運用で確認すべきリスク
【結論】
Drift監視を追加しても、損失やドローダウンは避けられません。検出器の誤警告、検出遅延、データ欠損、約定環境の変化を前提に、EAが安全側へ遷移できるか確認します。
11.1 取引コストと約定差
バックテストと実運用では、スプレッド、手数料、スリッページ、約定遅延が異なる場合があります。モデルの予測性能が同じでも、コスト増加によって実現損益が悪化することがあります。市場モデルのドリフトと執行品質の悪化は別のログで監視します。
11.2 ブローカーと口座仕様
最小ロット、最大ロット、ロットステップ、ストップレベル、フリーズレベル、取引時間は銘柄やブローカーで異なります。リスク縮小時の計算結果が最小ロット未満なら、新規注文を出さない判断も必要です。netting口座とhedging口座では既存ポジションの管理方法も異なります。
11.3 停止処理と既存ポジション
「新規エントリー停止」と「既存ポジションの即時決済」は同じではありません。警告時に既存ポジションをどう扱うか、決済によるスプレッド負担や流動性低下も含めて事前に定義します。
11.4 データ品質と時刻同期
欠損バー、重複データ、サーバー時刻、夏時間、CSV出力の遅延があると、誤警告につながります。VPS再起動後に基準窓が消える設計なら、十分なデータが再蓄積されるまで売買を停止するなどの初期化条件が必要です。
11.5 資金とレバレッジ
高いレバレッジは小さな価格変動でも口座損益を大きく動かします。Drift警告が遅れる可能性を前提に、最大ドローダウン、1取引の許容損失、総エクスポージャーを別のリスク管理モジュールで制限します。
バックテスト結果は将来の利益を保証しません。実運用前には、約定条件を含むフォワードテストが必要です。
12. よくある設計ミス
【結論】
最も多い設計ミスは、Covariate Shiftの兆候だけでConcept Driftと断定し、単発の警告を注文や再最適化へ直結させることです。監視対象、ラベル、閾値、対応条件を分離して記録します。
- 一時的なドローダウンだけでConcept Driftと判断する
- ATRや価格分布の変化だけで予測関係が崩れたと断定する
- 未確定足の値でスコアを何度も更新する
- 予測時には未知だった将来データを特徴量へ混入させる
- 検出指標とEAの損益指標を混ぜる
- 同じ期間で窓幅と閾値を繰り返し最適化する
- 1回の警告で全ポジションを無条件に決済する
- 警告解除条件や再起動後の復帰条件を決めない
- 再学習したモデルをOOS評価なしで実運用へ反映する
- スプレッドや約定差をモデルのConcept Driftと誤認する
13. 導入手順
【結論】
最初は1つの特徴量と1つの予測損失を記録し、警告だけを出す監視モードから始めます。検出性能を確認してから、段階的なリスク制御へ接続します。
- EAの入力
X、目的Y、予測時刻、ラベル確定時刻を定義する - MQL5で確定足の特徴量、予測値、モデルID、スプレッドを記録する
- ラベル確定後に予測損失を追記する
- Pythonで特徴量分布と損失系列を別々に可視化する
- 合成ドリフトで誤警告と検出遅延を測る
- 過去データを時系列順に分け、OOSとWalk Forwardで閾値を評価する
- フォワード環境では警告だけを記録する
- 運用上の効果と副作用を確認してから、リスク縮小や停止へ接続する
14. まとめ
Concept Drift Detectionは、過去に成立した特徴量と予測対象・EA成果との関係 P_t(Y|X) が現在も維持されているかを監視する考え方です。Distribution Shiftは P(X,Y) の変化を広く表し、Covariate Shiftはそのうち入力分布 P(X) が変わっても P(Y|X) が基本的に維持されるケースです。Regime DetectionやChange Point Detectionは、状態分類や変化時点の推定という別の問いを扱います。
MetaTrader 5は、特徴量取得、確定足での軽量監視、ログ保存、EAの運用制御に向いています。Pythonは、予測誤差の監視、統計検定、可視化、閾値探索、OOS・Walk Forward評価に向いています。
検出器には誤警告と検出遅延があります。警告は売買シグナルとして使わず、再学習、モデル切替、リスク縮小、停止の判断を別の検証済みルールで行うことが重要です。
関連トピック
- Concept DriftとDistribution Shiftの違い
- MQL5でDrift Scoreを記録するEA設計
- PythonでADWINを使ったモデル監視
- Change Point Detectionを金融時系列へ適用する方法
- Regime DetectionとEAの状態管理
- Walk Forward分析でモデル劣化を検証する方法
FAQ
Concept Drift Detectionとは何ですか?
Concept Drift Detectionとは、時間の経過によって入力と予測対象の関係が変化していないかを監視する方法です。EAでは、特徴量と将来リターン、予測値と正解ラベル、売買判断と実現結果の関係を対象にできます。
Distribution Shiftとの違いは何ですか?
Distribution Shiftは、学習時と運用時で同時分布 P(X,Y) が変化する状況を広く表す上位概念です。入力分布 P(X) が変わり、P(Y|X) が基本的に維持されるケースはCovariate Shift、P(Y|X) 自体が時間変化するケースはConcept Driftと整理します。
EAのドローダウンはConcept Driftの証拠ですか?
ドローダウンだけではConcept Driftの証拠になりません。標本のばらつき、スプレッド、スリッページ、約定遅延、取引回数の減少でも損益は悪化するため、予測誤差とデータ分布を分けて確認します。
Concept Drift Detectionを売買シグナルにできますか?
Concept Drift Detectionは、市場・モデル監視として売買シグナルから分離するのが基本です。警告は運用継続、リスク縮小、停止、再評価を検討する情報として扱います。
MQL5だけで高度なDrift Detectionを実装できますか?
軽量な移動統計や外部スコアの利用はMQL5で実装できます。多変量の統計検証、学習、可視化、閾値探索はPython側へ分離した方が検証と保守を行いやすくなります。
Driftが検出されたら自動で再最適化すべきですか?
自動再最適化が常に適切とは限りません。新しいモデルは過剰適合する可能性があるため、OOS、Walk Forward、フォワードテストの合格条件を満たしてから切り替えます。
OOSとWalk ForwardはConcept Drift Detectionの代わりになりますか?
代わりにはなりません。OOSとWalk Forwardは開発・更新手順の時間的な汎化を評価し、Concept Drift Detectionは運用中の変化を継続監視する役割を持ちます。
Drift検出の閾値はどう決めますか?
合成ドリフトと時系列順のOOSデータを使い、誤警告数と検出遅延のバランスで決めます。同じ期間で閾値を繰り返し調整すると過剰最適化になりやすいため、最終評価期間は分離します。