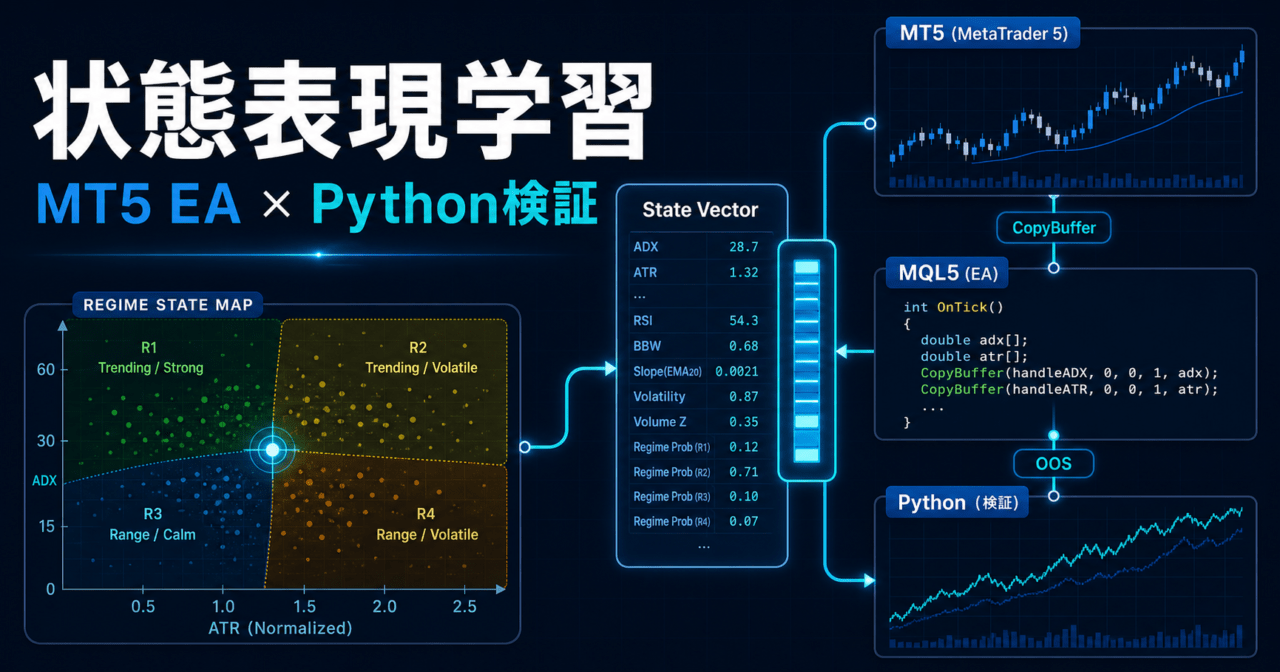

State Representation Learningとは何か
State Representation Learningは、観測データをそのまま使うのではなく、意思決定や制御に使いやすい「状態」に変換するための研究テーマです。
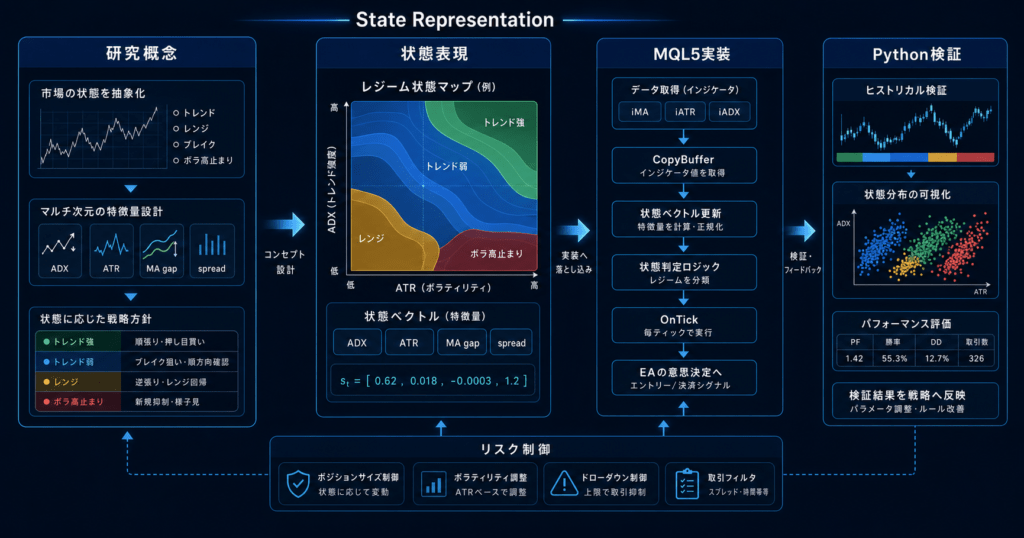
MetaTrader 5のExpert Advisorで考えると、価格、出来高、スプレッド、インジケータ値、時間帯、直近の変動率などは観測データです。これらをそのまま売買ロジックに入れると、入力が多すぎたり、相場の意味が混ざったり、過去データに合わせすぎたりします。State Representation Learningでは、この観測データから「今はトレンドが強い」「ボラティリティが高い」「レンジに近い」「売買判断には不十分」といった、より扱いやすい内部状態を作る考え方を取ります。
この考え方は、強化学習、ロボティクス、時系列モデリングで使われることが多いですが、EA開発でも有用です。特に、売買シグナルそのものを直接学習する前に、相場をどのような状態として表すかを整理すると、検証しやすい設計になります。
この記事の結論
State Representation Learningは、相場データからEAが扱いやすい状態ベクトルを作るための考え方です。MQL5では、OnInitでインジケータハンドルを作り、OnTickでCopyBufferにより観測値を取得し、正規化やカテゴリ化を通じて状態を構成する流れになります。実運用では、状態表現の精度だけでなく、スプレッド、約定、ロット制限、ドローダウン、フォワードテストの劣化を必ず分けて確認する必要があります。
この記事の要点
State Representation Learningは、価格やインジケータなどの観測値を、EAが判断に使いやすい「相場状態」として整理する考え方です。
MT5のEAでは、この状態表現をすぐに「買い」「売り」の結論へ結び付けるのではなく、まず相場環境を判定する材料として使います。たとえば、トレンド強度、ボラティリティ、移動平均からの乖離、スプレッド状態をまとめ、エントリー可否やフィルター判定に利用します。
EA開発に応用する場合は、状態表現そのものの精度だけで判断しないことが重要です。時系列分割、アウトオブサンプル検証、Walk Forward検証、スプレッドや約定差を含めた評価まで確認して、実運用で使える形に落とし込みます。
初心者向けの理解
EAの設計では、価格が上がったか下がったかだけを見て売買するよりも、現在の相場がどのような状態にあるかを先に判定した方が扱いやすい場合があります。
たとえば、同じ移動平均クロスでも、強いトレンド中と方向感のないレンジ中では意味が異なります。State Representation Learningは、この違いを「生の価格」ではなく「状態」として表現する発想です。
状態表現の例は次のようになります。
| 状態要素 | 内容 | EAでの使い方 |
|---|---|---|
| トレンド強度 | ADXや移動平均傾きで方向性を見る | トレンドフォローの有効条件にする |
| 変動率 | ATRや標準偏差で値動きの大きさを見る | ロット、損切り幅、停止条件に使う |
| 乖離 | 現在価格と移動平均の距離を見る | 過熱感や押し目候補を見る |
| スプレッド状態 | 取引コストが通常範囲かを見る | エントリー停止条件にする |
| 時間帯 | セッションや流動性を分ける | 低流動性の時間を避ける |
このように、State Representation Learningは「当てるモデル」ではなく「見やすい地図を作るモデル」と考えると理解しやすくなります。
Regime Detectionとの違い
Regime Detectionは、相場をトレンド、レンジ、高ボラティリティ、低ボラティリティなどの状態に分類する考え方です。State Representation Learningは、その分類に使う材料や内部表現を作る、より広い考え方です。
| 観点 | State Representation Learning | Regime Detection |
|---|---|---|
| 主な目的 | 観測データを使いやすい状態に変換する | 相場環境を分類する |
| 出力 | 連続値のベクトル、スコア、特徴量 | 状態ラベルやクラス |
| EAでの使い方 | フィルター、モデル入力、リスク調整 | 売買ルールの切り替え |
| 注意点 | 表現が売買に有効とは限らない | 分類が遅れる場合がある |
EAで実装する場合、まず手作りの状態表現から始めるのが現実的です。ADX、ATR、移動平均、スプレッド、時間帯を組み合わせれば、複雑な深層学習を使わなくても状態表現の基礎を作れます。
EA開発での使い道
State Representation LearningをEAに取り入れる場合、最初から深層学習モデルをMQL5へ組み込む必要はありません。初心者から中級者向けには、次のような段階が扱いやすいです。
- MQL5で観測値を取得する
- 観測値を正規化する
- 状態スコアを作る
- 状態に応じて売買フィルターを変える
- Pythonで検証し、MQL5側へ単純な形で戻す
たとえば、状態を「トレンド強度」「ボラティリティ」「取引コスト」の3つに分けるだけでも、EAの設計は整理しやすくなります。
| 状態 | 低い場合 | 高い場合 |
|---|---|---|
| トレンド強度 | 逆張りまたは停止を検討 | トレンドフォローを検討 |
| ボラティリティ | 利幅が小さくなりやすい | 損切り幅とロットを調整 |
| 取引コスト | 通常運用しやすい | エントリー停止を検討 |
ここで重要なのは、状態表現を作っただけでEAが有利になるわけではないことです。状態表現は売買判断の材料であり、エントリー、決済、ロット管理、損切り、稼働停止条件と組み合わせて初めて評価できます。
MQL5での実装イメージ
MQL5では、インジケータの値を直接毎回計算するのではなく、OnInitでハンドルを作成し、OnTickで必要なバッファを取得する構成にします。CopyBufferで取得した値を使い、EA内部の状態を更新します。
//+------------------------------------------------------------------+
//| State Representation Learning style filter sample for MT5 EA     |
//+------------------------------------------------------------------+
#property strict

input int    InpFastMAPeriod = 20;
input int    InpSlowMAPeriod = 80;
input int    InpATRPeriod    = 14;
input int    InpADXPeriod    = 14;
input double InpMaxSpreadPts = 30.0;

int fast_ma_handle = INVALID_HANDLE;
int slow_ma_handle = INVALID_HANDLE;
int atr_handle     = INVALID_HANDLE;
int adx_handle     = INVALID_HANDLE;

struct MarketState
{
   double trend_score;
   double volatility_score;
   double cost_score;
   bool   tradable;
};

int OnInit()
{
   fast_ma_handle = iMA(_Symbol, _Period, InpFastMAPeriod, 0, MODE_EMA, PRICE_CLOSE);
   slow_ma_handle = iMA(_Symbol, _Period, InpSlowMAPeriod, 0, MODE_EMA, PRICE_CLOSE);
   atr_handle     = iATR(_Symbol, _Period, InpATRPeriod);
   adx_handle     = iADX(_Symbol, _Period, InpADXPeriod);

   if(fast_ma_handle == INVALID_HANDLE ||
      slow_ma_handle == INVALID_HANDLE ||
      atr_handle     == INVALID_HANDLE ||
      adx_handle     == INVALID_HANDLE)
   {
      return INIT_FAILED;
   }

   return INIT_SUCCEEDED;
}

void OnDeinit(const int reason)
{
   if(fast_ma_handle != INVALID_HANDLE) IndicatorRelease(fast_ma_handle);
   if(slow_ma_handle != INVALID_HANDLE) IndicatorRelease(slow_ma_handle);
   if(atr_handle     != INVALID_HANDLE) IndicatorRelease(atr_handle);
   if(adx_handle     != INVALID_HANDLE) IndicatorRelease(adx_handle);
}

bool ReadLatestValue(const int handle, const int buffer_index, double &value)
{
   double data[];
   ArraySetAsSeries(data, true);

   if(CopyBuffer(handle, buffer_index, 0, 1, data) != 1)
      return false;

   value = data[0];
   return true;
}

bool BuildMarketState(MarketState &state)
{
   double fast_ma, slow_ma, atr_value, adx_value;

   if(!ReadLatestValue(fast_ma_handle, 0, fast_ma))   return false;
   if(!ReadLatestValue(slow_ma_handle, 0, slow_ma))   return false;
   if(!ReadLatestValue(atr_handle,     0, atr_value)) return false;
   if(!ReadLatestValue(adx_handle,     0, adx_value)) return false;

   MqlTick tick;
   if(!SymbolInfoTick(_Symbol, tick))
      return false;

   double point = SymbolInfoDouble(_Symbol, SYMBOL_POINT);
   if(point <= 0.0)
      return false;

   double spread_points = (tick.ask - tick.bid) / point;
   double price = (tick.ask + tick.bid) * 0.5;

   state.trend_score      = MathAbs(fast_ma - slow_ma) / MathMax(point, price * 0.001);
   state.volatility_score = atr_value / MathMax(point, price * 0.001);
   state.cost_score       = spread_points / InpMaxSpreadPts;
   state.tradable         = (spread_points <= InpMaxSpreadPts && adx_value >= 20.0);

   return true;
}

void OnTick()
{
   MarketState state;
   if(!BuildMarketState(state))
      return;

   if(!state.tradable)
      return;

   // ここでエントリー条件、OrderCheck、OrderSend前のロット制限を別途確認する
}
このコードは、State Representation Learningの考え方をEA内の状態表現として単純化した例です。実際の売買処理では、OrderCheckによる事前確認、最小ロット、最大ロット、ロットステップ、証拠金、スリッページ、ポジション保有数の制限を別に実装します。
Python検証へのつなげ方
State Representation Learningを本格的に検証する場合、Pythonで状態表現を作り、期間別に性能を確認する流れが有効です。
最初の検証では、深層学習よりも単純な特徴量から始めます。たとえば、次のような列を作ります。
| 列名 | 内容 |
|---|---|
| return_1 | 1本前からのリターン |
| ma_gap | 短期移動平均と長期移動平均の乖離 |
| atr_norm | 価格に対するATR比率 |
| adx | トレンド強度 |
| spread_norm | 通常スプレッドに対する比率 |
| hour | 時間帯 |
この状態表現を使い、次のような検証を行います。
import pandas as pd

def build_state_features(df: pd.DataFrame) -> pd.DataFrame:
    out = df.copy()
    out["return_1"] = out["close"].pct_change()
    out["ma_fast"] = out["close"].rolling(20).mean()
    out["ma_slow"] = out["close"].rolling(80).mean()
    out["ma_gap"] = (out["ma_fast"] - out["ma_slow"]) / out["close"]
    out["range_norm"] = (out["high"] - out["low"]) / out["close"]
    out["volatility_20"] = out["return_1"].rolling(20).std()
    out["hour"] = out.index.hour
    return out.dropna()

def split_by_time(df: pd.DataFrame, train_end: str, test_start: str) -> tuple[pd.DataFrame, pd.DataFrame]:
    train = df.loc[:train_end].copy()
    test = df.loc[test_start:].copy()
    return train, test
ここで避けたいのは、全期間で最も良く見える特徴量を選び、そのまま同じ期間で評価することです。これは過剰最適化になりやすく、実運用では期待通りに動かない原因になります。検証では、学習期間、調整期間、アウトオブサンプル期間、フォワードテスト期間を分けます。
状態表現の評価方法
状態表現が良いかどうかは、単にバックテストの利益だけでは判断しにくいです。売買ルール、手数料、スプレッド、約定条件、検証期間の選び方で結果が大きく変わるためです。
評価では、次の観点を分けます。
| 評価対象 | 見る内容 | 注意点 |
|---|---|---|
| 表現の安定性 | 状態スコアが極端に揺れないか | ノイズに反応しすぎると売買回数が増える |
| 分離性 | トレンド期とレンジ期を区別できるか | 後付け分類になっていないかを見る |
| 汎化性 | 別期間でも似た傾向があるか | 期間をずらして確認する |
| 取引可能性 | コスト込みで成立するか | スプレッドと約定を含める |
| 実装容易性 | MQL5へ落とし込めるか | 複雑すぎる表現は保守しにくい |
特にEAでは、状態表現がきれいに見えても、実際の取引で使えないことがあります。たとえば、状態の切り替わりが遅い、スプレッド拡大時にシグナルが集中する、ボラティリティ急変でロット管理が追いつかない、といった問題です。
バックテストとフォワードテストの違い
バックテストは、過去データに対してEAを動かして結果を見る検証です。フォワードテストは、まだ最適化に使っていない期間やリアルタイムに近い環境で挙動を見る検証です。
State Representation LearningをEAに使う場合、バックテストだけでは不十分です。状態表現は過去の相場構造に合わせて作られるため、未来の相場で同じように働くとは限りません。
| 検証 | 目的 | 主な確認点 |
|---|---|---|
| バックテスト | 実装ミスや大まかな傾向を見る | 取引回数、DD、コスト耐性 |
| アウトオブサンプル | 未使用期間で劣化を見る | 最適化後の崩れ方 |
| Walk Forward | 期間をずらして再評価する | 状態表現の安定性 |
| フォワードテスト | 実運用に近い挙動を見る | 約定、スプレッド、停止条件 |
過去データで状態表現が有効に見えても、実運用ではサーバー遅延、約定拒否、スリッページ、口座タイプ、銘柄仕様の違いが影響します。したがって、バックテスト結果をそのまま将来の成果として扱うのは危険です。
実運用で確認すべきリスク
State Representation Learningは、EAの判断材料を整理するための考え方です。状態表現を作っただけで、売買成績が安定するわけではありません。
実運用を考える場合は、モデルの見た目の精度よりも、取引条件を含めた検証を優先します。特に次の点は、バックテスト段階から分けて確認します。
| 確認項目 | 起きやすい問題 | 確認方法 |
|---|---|---|
| 過剰最適化 | 過去データに合わせすぎる | OOSとWalk Forwardで確認する |
| 取引コスト | スプレッドや手数料を軽く見積もる | コストを保守的に設定する |
| 約定差 | バックテストと実運用で約定条件が変わる | デモ口座や小ロットで挙動を見る |
| ドローダウン | 想定以上の連敗や損失が出る | 最大損失と停止条件を決める |
| レバレッジ | 損失が短時間で拡大する | ロット上限と証拠金維持率を確認する |
EAでは、状態表現が複雑になるほど、どの要因で成績が変わったのかを追いにくくなります。複雑なモデルを使う場合ほど、期間分割、銘柄分散、パラメータ固定、取引コスト、ロット制限を明確にしてから評価することが重要です。
実装時の設計パターン
初心者から中級者が取り組む場合、次の設計が扱いやすいです。
| 設計段階 | 内容 | MQL5での実装 |
|---|---|---|
| 観測 | 価格、MA、ATR、ADX、スプレッドを取得 | iMA、iATR、iADX、SymbolInfoTick |
| 状態化 | スコアやカテゴリに変換 | 構造体や関数で管理 |
| フィルター | 売買可能な環境か判定 | OnTick内で早期return |
| 売買判断 | エントリー条件を見る | シグナル関数を分離 |
| 注文前確認 | ロット、証拠金、制限を確認 | OrderCheckを使う |
| 検証 | 期間を分けて評価 | MT5ストラテジーテスターとPython |
この分け方にすると、状態表現の問題と売買ロジックの問題を切り分けやすくなります。たとえば、取引成績が悪い場合でも、状態表現が悪いのか、エントリー条件が悪いのか、ロット管理が悪いのかを調べやすくなります。
よくある失敗
State Representation LearningをEAに応用するときの失敗は、技術そのものよりも検証設計に多くあります。
| 失敗 | 問題 | 改善 |
|---|---|---|
| 状態数を増やしすぎる | 解釈できず、最適化しやすくなる | まず3から5個程度に絞る |
| 利益だけで選ぶ | 偶然の期間に合いやすい | DD、取引回数、OOSも見る |
| スプレッドを無視する | 実運用で成績が崩れやすい | スプレッド上限を状態に含める |
| モデルを複雑にしすぎる | MQL5実装と保守が難しい | Pythonで検証し、EAには単純化して移す |
| フォワードを省く | 過去最適化に気づきにくい | 小ロットまたはデモで確認する |
State Representation Learningは、複雑なAIモデルを入れれば良いという話ではありません。EAで使うなら、状態表現の意味、取得方法、検証方法、注文制御まで一貫して設計することが重要です。
関連研究資料
- State Representation Learning for Control: An Overview
- Learning State Representations with Robotic Priors
- Deep Variational Bayes Filters: Unsupervised Learning of State Space Models from Raw Data
まとめ
State Representation Learningは、EAが相場を扱いやすくするための状態表現を作る考え方です。価格やインジケータをそのまま売買条件にするのではなく、トレンド、ボラティリティ、取引コスト、時間帯などを整理して、内部状態として扱います。
MQL5では、OnInitでインジケータハンドルを作り、OnTickでCopyBufferから値を取得し、状態構造体にまとめる設計が実装しやすいです。Pythonでは、時系列分割、アウトオブサンプル、Walk Forwardを使って、状態表現が特定期間だけに合っていないか確認します。
重要なのは、状態表現が高度であることではなく、実運用で検証できることです。スプレッド、約定、ロット制限、ドローダウン、フォワードテストの劣化を含めて評価することで、研究テーマをEA開発に現実的に翻訳できます。
FAQ
State Representation LearningはEAの利益を増やす技術ですか?
利益を直接増やす技術ではありません。価格やインジケータをEAが扱いやすい状態に変換する考え方です。売買成績は、エントリー、決済、ロット管理、取引コスト、検証条件によって変わります。
MT5のEAでは深層学習モデルが必要ですか?
必須ではありません。初心者から中級者の場合、MA、ATR、ADX、スプレッド、時間帯などを使った手作りの状態表現から始める方が検証しやすいです。
Regime DetectionとState Representation Learningは同じですか?
同じではありません。Regime Detectionは相場状態を分類する考え方で、State Representation Learningはその分類や判断に使う状態表現を作る広い考え方です。
MQL5ではどの関数が重要ですか?
インジケータハンドルを作るiMA、iATR、iADX、値を取得するCopyBuffer、価格とスプレッドを確認するSymbolInfoTickが重要です。注文前にはOrderCheckによる確認も必要です。
バックテストで良ければ実運用してよいですか?
バックテストだけで判断するのは危険です。アウトオブサンプル、Walk Forward、フォワードテストを通じて、過去データへの合わせすぎや取引コストの影響を確認する必要があります。